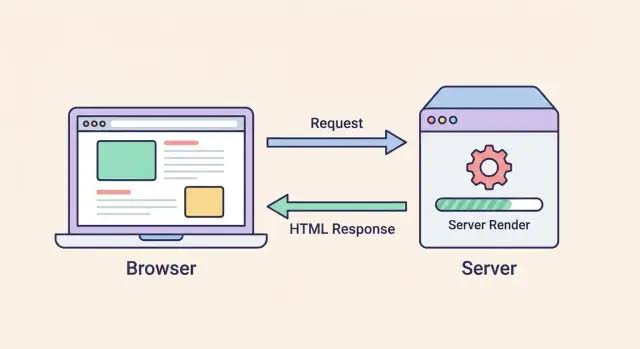
在传统前端开发中,浏览器通常负责执行 JavaScript、请求接口并生成页面内容。随着应用规模不断扩大,页面首屏加载、搜索引擎优化、数据获取和缓存策略逐渐成为前端架构设计中的重要问题。服务端渲染(Server-Side Rendering,SSR)正是解决这些问题的一种重要技术。
如今,Next.js 和 Nuxt 分别成为 React 与 Vue 生态中具有代表性的全栈 Web 框架。它们不仅支持服务端渲染,还整合了路由、数据获取、静态生成、缓存和服务端接口等能力,使前端应用逐渐从单纯的浏览器应用发展为可以运行在服务端与客户端之间的完整 Web 应用。
本文将从渲染原理出发,介绍 SSR 的工作机制、不同渲染模式的区别,以及 Next.js 和 Nuxt 的实现方式与架构差异。
一、什么是服务端渲染
1. 从浏览器渲染说起
一个网页最终都需要经过浏览器处理,才能显示成用户看到的页面。但页面 HTML 可以由不同的地方生成。
在传统的客户端渲染(Client-Side Rendering,CSR)模式中,服务端通常只返回一个基础 HTML 文件,页面主体由浏览器执行 JavaScript 后生成。
例如,一个使用 Vue 构建的简单页面可能返回:
<!DOCTYPE html>
<html>
<head>
  <title>我的博客</title>
</head>
<body>
  <div id="app"></div>
  <script src="/assets/app.js"></script>
</body>
</html>
浏览器收到 HTML 后,先看到的是一个空的应用容器。随后浏览器下载 JavaScript,执行 Vue 应用,获取文章数据,再将文章列表渲染到页面中。
其过程大致如下:
浏览器
  |
  | 请求页面
  v
Web 服务
  |
  | 返回基础 HTML 和 JS 资源地址
  v
浏览器解析 HTML
  |
  | 下载并执行 JavaScript
  v
请求业务 API
  |
  | 获取文章数据
  v
执行组件渲染
  |
  v
显示页面内容
这种方式有很多优势,例如前后端职责分离清晰、静态资源容易部署到 CDN、页面交互开发方便。但它也存在一些问题:
- 页面主体依赖 JavaScript 执行后才能生成。
- 首次访问时,需要额外下载、解析和执行脚本。
- 搜索引擎或其他爬虫需要能够正确处理 JavaScript,才能获取完整页面内容。
- JavaScript 执行失败时,页面可能无法正常显示。
需要说明的是,现代搜索引擎能够处理相当一部分 JavaScript 内容,因此 CSR 并不意味着一定无法被搜索引擎收录。真正的问题是,不同爬虫的执行能力、抓取预算和处理时机并不相同。
2. 服务端渲染的工作方式
服务端渲染的核心思想是:在服务端执行页面渲染逻辑,生成 HTML,再将已经包含页面内容的 HTML 返回给浏览器。
例如,用户访问博客文章:
GET /posts/hello-world
服务端读取文章数据,执行页面组件渲染,生成完整 HTML:
<!DOCTYPE html>
<html>
<head>
  <title>服务端渲染入门</title>
</head>
<body>
  <div id="app">
    <h1>服务端渲染入门</h1>
    <p>本文介绍 SSR 的基本原理。</p>
  </div>
  <script src="/assets/app.js"></script>
</body>
</html>
浏览器收到响应后,可以在 JavaScript 尚未执行时就显示文章标题和正文。
其流程如下:
浏览器
  |
  | 请求页面
  v
SSR 服务
  |
  | 查询文章数据
  | 执行组件渲染
  | 生成 HTML
  v
返回包含内容的 HTML
  |
  v
浏览器解析并显示页面
  |
  | 下载并执行客户端 JavaScript
  v
Hydration(水合)
  |
  v
页面具备完整交互能力
SSR 的一个关键优势是,浏览器更早拿到有意义的页面内容。对于博客、新闻、商品详情和营销页面,这通常非常有价值。
不过,SSR 不代表页面从此不需要 JavaScript。很多 SSR 框架还会在浏览器端加载客户端代码,对服务端生成的 HTML 进行水合(Hydration),从而为按钮、表单、菜单等组件绑定事件并恢复交互状态。
如果一个页面完全不需要客户端交互,也可以选择不发送相应的客户端 JavaScript,但这取决于框架的架构和页面实现方式。
3. SSR 为什么有利于 SEO
搜索引擎需要理解页面的标题、正文、链接、结构化数据等内容。
如果服务端直接返回包含文章内容的 HTML,爬虫就可以在获取文档时读取这些信息,而不必完全依赖 JavaScript 执行。
例如,博客文章可以在服务端生成:
<head>
  <title>Node.js 性能优化实践</title>
  <meta
    name="description"
    content="介绍 Node.js 服务的常见性能优化方法。"
  />
  <link
    rel="canonical"
    href="https://example.com/posts/nodejs-performance"
  />
</head>
<body>
  <article>
    <h1>Node.js 性能优化实践</h1>
    <p>从事件循环、数据库和缓存等方面进行分析。</p>
  </article>
</body>
这样可以让爬虫更直接地获取主要内容,也更容易正确提取页面标题和描述。
但 SSR 并不自动等于良好的 SEO。页面仍然需要合理的 URL、可访问的内部链接、正确的状态码、唯一的标题与描述、规范链接以及适当的结构化数据。
如果服务端返回的仍然是空页面,或者所有路由都返回相同的元信息,那么即使使用 SSR,也未必能够获得理想的搜索表现。
二、SSR、CSR、SSG 与 ISR 有什么区别
服务端渲染只是页面渲染架构的一种选择。实际项目中,还经常会遇到 CSR、SSG 和 ISR。
1. CSR:客户端渲染
CSR 将主要的页面渲染工作交给浏览器。
优点是前端部署相对简单,服务端可以专注于提供 API,静态资源也容易通过 CDN 分发。缺点是页面主体通常需要等待 JavaScript 执行和数据请求。
适合后台管理系统、内部运营平台、复杂交互应用等场景。对于已经登录、以操作为主的后台页面,SSR 带来的收益往往没有公开内容型网站那么明显。
2. SSR:请求时服务端渲染
SSR 通常在请求到达时,由服务端获取所需数据并生成 HTML。
例如:
用户请求文章页面
       |
       v
服务端查询文章数据
       |
       v
生成 HTML
       |
       v
返回浏览器
优点是可以根据当前请求生成页面内容,适合需要较新数据、个性化内容或动态页面的场景。
缺点是每次请求都可能触发服务端渲染和数据获取,增加服务器的 CPU、内存、数据库及网络开销。
实际项目可以通过页面缓存、数据缓存和 CDN 降低这些成本。
3. SSG:构建时静态生成
静态站点生成(Static Site Generation,SSG)会在构建阶段提前生成 HTML 文件。
例如,一个包含 1,000 篇文章的博客,可以在构建时生成 1,000 个 HTML 文件。用户访问时,Web 服务或 CDN 直接返回对应文件,而不必每次都运行服务端渲染逻辑。
构建阶段
   |
   v
读取文章数据
   |
   v
生成静态 HTML 文件
   |
   v
部署到 CDN
   |
   v
用户直接获取页面
SSG 的优点是响应快、服务器成本低、部署简单。缺点是数据更新通常需要重新生成页面,或者结合其他更新机制处理。
适合个人博客、文档网站、产品介绍和更新频率较低的内容网站。
4. ISR:增量静态再生成
增量静态再生成(Incremental Static Regeneration,ISR)试图结合静态生成和动态更新的优势。
页面可以先以静态资源形式提供,在设定的策略下重新生成或刷新缓存,避免每次请求都重新执行完整渲染。
其基本思路是:
请求页面
   |
   v
检查静态页面或缓存
   |
   +---- 缓存可用 ----> 直接返回
   |
   v
按策略重新生成或刷新
   |
   v
后续请求使用更新后的结果
需要注意,ISR 的具体行为依赖框架和缓存策略。某些模式允许先返回旧内容、后台重新生成;另一些模式则可能在重新验证时等待更新结果。
Next.js 和 Nuxt 对静态生成、缓存与重新验证的 API 并不完全相同,因此不能直接将一个框架的 ISR 配置复制到另一个框架。
5. 四种模式的对比
| 维度 | CSR | SSR | SSG | ISR / 增量更新 |
|---|---|---|---|---|
| HTML 生成时机 | 浏览器运行时 | 请求时 | 构建时 | 构建时生成,按策略更新 |
| 首屏内容 | 依赖客户端渲染 | 通常较早获得 | 通常较早获得 | 通常较早获得 |
| 服务端计算 | 主要是 API 处理 | 每次动态渲染可能需要 | 主要在构建阶段 | 取决于重新生成和缓存 |
| 数据新鲜度 | 由客户端请求决定 | 可在请求时获取最新数据 | 通常取决于最近一次构建 | 取决于重新验证策略 |
| 个性化支持 | 方便 | 方便 | 通常不适合直接个性化 | 通常需要动态处理个性化部分 |
| 典型场景 | 管理后台、交互应用 | 动态内容、个性化页面 | 博客、文档、营销页 | 内容网站、商品详情 |
这里的“首屏较快”是一般趋势,不是绝对保证。SSR 可能因为服务端查询慢而推迟首字节到达时间;CSR 如果缓存命中且脚本体积很小,也可能表现良好。
选择渲染模式时,应同时关注真实用户体验指标,例如 LCP(最大内容绘制)、TTFB(首字节时间)、INP(交互到下一次绘制)和 CLS(累积布局偏移),而不只是看是否采用 SSR。
三、Next.js:React 生态中的服务端渲染框架
Next.js 是基于 React 的 Web 框架。它在 React 的组件体系之上提供文件路由、服务端渲染、静态生成、缓存、服务端数据获取和服务端接口等能力。
Next.js 的重要特点之一,是它不仅提供传统 SSR,还围绕 Server Components、客户端组件和缓存机制形成了自己的应用架构。
需要区分 Next.js 的 App Router 和旧版 Pages Router:两者的数据获取方式和渲染模型有所不同。下面主要介绍当前主流的 App Router。
1. App Router 的目录结构
一个简单的 Next.js 博客项目可能采用这样的目录:
my-blog/
├── app/
│   ├── layout.tsx
│   ├── page.tsx
│   ├── posts/
│   │   └── [id]/
│   │       └── page.tsx
│   └── api/
│       └── posts/
│           └── route.ts
├── components/
├── lib/
│   └── posts.ts
├── public/
└── package.json
其中:
app/page.tsx对应首页。app/layout.tsx定义共享布局。app/posts/[id]/page.tsx对应动态文章详情路由。app/api/posts/route.ts可以定义服务端 API 路由。lib/posts.ts可以封装数据库查询或数据访问逻辑。
这种基于目录结构的路由方式,可以减少手动维护路由表的工作。
2. 使用 Server Component 获取文章数据
在 App Router 中,组件默认是 React Server Component,除非显式使用 'use client' 将组件定义为客户端组件。
例如,文章详情页可以写成:
// app/posts/[id]/page.tsx

interface Post {
  id: string;
  title: string;
  content: string;
}

async function getPost(id: string): Promise<Post> {
  const response = await fetch(
    `${process.env.API_BASE_URL}/posts/${id}`,
    {
      cache: 'no-store',
    },
  );

  if (!response.ok) {
    throw new Error('获取文章失败');
  }

  return response.json();
}

export default async function PostPage({
  params,
}: {
  params: Promise<{ id: string }>;
}) {
  const { id } = await params;
  const post = await getPost(id);

  return (
    <article>
      <h1>{post.title}</h1>
      <div>{post.content}</div>
    </article>
  );
}
这里有几个重要细节。
第一,组件可以直接声明为 async,在服务端等待数据获取完成,再生成页面。
第二,示例使用 cache: 'no-store',表示这次 fetch 不使用 Next.js 的持久化数据缓存。它适合希望每次请求都获取最新数据的场景,但会增加下游 API 的访问量。
第三,当前 Next.js App Router 的动态路由参数在较新版本中通常需要通过 Promise 形式的 params 获取。不同版本之间可能存在差异,升级项目时应以所使用版本的官方文档为准。
第四,Server Component 并不意味着组件必须在浏览器中再次执行。它可以在服务端获取数据并生成 HTML,同时向客户端输出相应的组件载荷。
3. Next.js 的缓存与重新验证
Next.js 的缓存策略需要明确区分几个概念:
- 请求级或组件级的数据获取。
- Data Cache:框架提供的数据缓存能力。
- Full Route Cache:针对可缓存路由输出的缓存。
- 客户端 Router Cache:用于客户端导航的路由数据缓存。
这些缓存的生命周期和失效机制并不完全相同。
例如,希望缓存文章数据一段时间,可以使用:
const response = await fetch(
  `${process.env.API_BASE_URL}/posts/${id}`,
  {
    next: {
      revalidate: 60,
    },
  },
);
这表示数据可以按照 60 秒的重新验证策略进行缓存管理。它并不等于“所有用户在每次访问时都严格得到 60 秒内的数据”,因为具体表现还与请求缓存、路由渲染方式和重新验证过程有关。
如果文章发布、编辑后需要主动更新缓存,还可以使用框架提供的 revalidatePath 或 revalidateTag 等机制。
在较新的 Next.js 版本中,缓存默认行为、缓存配置和 Cache Components 等能力会随版本变化,因此不应简单地认为所有 fetch 都默认缓存,或者所有页面默认都是静态页面。开发时需要明确指定并验证页面的渲染和缓存策略。
4. Server Component 与 Client Component
Next.js App Router 中另一个重要概念是 Server Component 和 Client Component。
Server Component 适合:
- 查询数据库。
- 读取服务端环境变量。
- 调用服务端业务逻辑。
- 生成不需要浏览器事件处理的内容。
- 减少发送到浏览器的 JavaScript。
Client Component 适合:
- 点击事件。
- 浏览器状态管理。
- 表单交互。
- 使用
useState、useEffect等客户端 Hook。 - 调用浏览器 API。
例如,一个点赞按钮可以定义为客户端组件:
'use client';

import { useState } from 'react';

export default function LikeButton() {
  const [count, setCount] = useState(0);

  return (
    <button onClick={() => setCount(count + 1)}>
      点赞 {count}
    </button>
  );
}
服务端负责生成文章主体,点赞按钮负责交互。这种组合允许页面主体尽可能利用服务端渲染,同时只将真正需要交互的部分交给浏览器。
需要注意,'use client' 并不意味着组件永远只在浏览器中渲染。客户端组件在初始页面加载时仍可能参与服务端预渲染;这个标记主要定义客户端组件边界及其模块依赖。
四、Nuxt:Vue 生态中的服务端渲染框架
Nuxt 是基于 Vue 的 Web 框架,提供文件路由、自动导入、服务端渲染、静态生成、数据获取和服务端 API 等能力。
对于已经熟悉 Vue 3 的开发者来说,Nuxt 的组件语法与普通 Vue 组件基本一致。它的主要区别在于:框架不仅运行在浏览器端,还可以在服务端参与路由处理、数据获取和 HTML 生成。
1. Nuxt 的目录结构
一个简单的 Nuxt 4 博客项目可以采用下面的结构:
my-blog/
├── app/
│   ├── app.vue
│   ├── pages/
│   │   ├── index.vue
│   │   └── posts/
│   │       └── [id].vue
│   └── components/
├── server/
│   └── api/
│       └── posts/
│           └── [id].get.ts
├── public/
├── nuxt.config.ts
└── package.json
Nuxt 3 的默认目录结构通常以项目根目录下的 pages/、components/ 等目录为基础;Nuxt 4 则采用更明确的 app/ 目录组织前端应用代码,同时保留项目根目录下的 server/ 目录用于服务端 API 和服务端逻辑。
这也是从 Nuxt 3 迁移到 Nuxt 4 时需要注意的区别之一。具体项目仍然应以实际的 srcDir 和 Nuxt 配置为准。
2. 使用 useFetch 获取文章数据
在 Nuxt 中,可以通过 useFetch 获取数据,并将结果用于服务端渲染。
例如,文章详情页面:
<!-- app/pages/posts/[id].vue -->

<script setup lang="ts">
const route = useRoute();

const { data: post, error } = await useFetch(
  `/api/posts/${route.params.id}`,
);

if (error.value) {
  throw createError({
    statusCode: 404,
    statusMessage: '文章不存在或暂时无法访问',
  });
}

useSeoMeta({
  title: () => post.value?.title ?? '文章详情',
  description: () => post.value?.summary ?? '',
});
</script>

<template>
  <article v-if="post">
    <h1>{{ post.title }}</h1>
    <p>{{ post.summary }}</p>
    <div>{{ post.content }}</div>
  </article>
</template>
这里的 useFetch 是 Nuxt 提供的组合式 API,不只是普通的 fetch 包装。
在初始 SSR 请求中,它可以在服务端执行数据获取,并将相关数据纳入页面的序列化状态,避免客户端水合时无条件重复执行相同的数据请求。
客户端进行页面导航时,它也可以在客户端环境下获取数据。
需要注意的是,useFetch 默认不会自动把所有异常业务状态都转换为 404。上面的代码只是一个简单示例;实际项目应该区分文章不存在、鉴权失败、接口超时和服务端错误,再映射到适当的 HTTP 状态码。
3. Nuxt 的 useAsyncData 与 useFetch
Nuxt 中经常会遇到 useFetch 和 useAsyncData,两者用途相近,但侧重点不同。
useFetch 适合直接请求 HTTP 接口:
const { data, pending, error, refresh } = await useFetch(
  '/api/posts',
);
useAsyncData 更适合封装复杂的数据获取逻辑:
const { data, pending, error } = await useAsyncData(
  'posts',
  async () => {
    const [posts, categories] = await Promise.all([
      $fetch('/api/posts'),
      $fetch('/api/categories'),
    ]);

    return {
      posts,
      categories,
    };
  },
);
在实际开发中,可以把多个请求合并成一个数据获取函数,减少组件中的重复逻辑。
不过,useAsyncData 的键值、缓存、刷新和响应式行为也需要根据具体使用方式进行设计。不要为了避免重复请求,给所有不同的数据使用同一个固定键值,否则可能出现数据复用不符合预期的情况。
4. 使用 Nuxt 服务端 API
Nuxt 不仅可以渲染页面,还可以通过 Nitro 提供服务端 API。
例如,定义文章接口:
// server/api/posts/[id].get.ts

export default defineEventHandler(async (event) => {
  const id = getRouterParam(event, 'id');

  if (!id) {
    throw createError({
      statusCode: 400,
      statusMessage: '缺少文章 ID',
    });
  }

  // 实际项目中可以在这里调用数据库服务
  const post = await findPostById(id);

  if (!post) {
    throw createError({
      statusCode: 404,
      statusMessage: '文章不存在',
    });
  }

  return post;
});
这里的 findPostById 是示意函数,需要在项目中实现或从对应服务模块导入。
如果页面和 API 部署在同一个 Nuxt 应用中,就可以使用相对路径访问 /api/posts/:id。如果数据来自独立的后端服务,也可以在服务端通过私有环境变量配置后端地址,再由 Nuxt 服务端进行调用。
这种方式可以将服务端密钥留在服务端,避免直接暴露到浏览器。不过,服务端 API 仍然需要正确实现身份认证、权限校验、输入验证和错误处理。
五、Next.js 与 Nuxt 的核心差异
Next.js 和 Nuxt 的目标非常相似:都希望开发者能够使用组件化方式构建现代 Web 应用,同时将路由、渲染、数据获取和部署能力整合到框架中。
但它们的设计理念和开发方式并不完全相同。
1. 技术栈与组件模型
| 对比项 | Next.js | Nuxt |
|---|---|---|
| 基础 UI 框架 | React | Vue |
| 主要组件语言 | JSX / TSX | Vue SFC、模板、<script setup> |
| 路由方式 | 文件路由 | 文件路由 |
| 服务端渲染 | 支持 | 支持 |
| 静态生成 | 支持 | 支持 |
| 服务端接口 | Route Handlers 等 | Nitro Server Routes |
| 数据获取 | Server Component、fetch 等 | useFetch、useAsyncData 等 |
| 交互状态 | React Hooks | Vue Composition API |
| 服务端组件模型 | App Router 中有明确的 Server/Client Component 区分 | 主要通过 Vue SSR、Nitro 和 Nuxt 数据层组织应用 |
| 服务端运行时 | Next.js Runtime / Node.js 等部署方式 | Nitro 支持多种部署预设 |
最大的差异首先来自 React 与 Vue 本身。
Next.js 使用 React 的组件和状态模型,开发者需要理解 JSX、Hooks、Server Component 与 Client Component 的边界。
Nuxt 则使用 Vue 的响应式系统和单文件组件语法,提供自动导入和基于约定的开发体验。
如果团队已经深度使用 Vue 3,Nuxt 的学习成本通常会更低;如果团队主要使用 React,Next.js 通常更加自然。
2. 数据获取方式不同
Next.js App Router 可以在 Server Component 中直接使用异步函数获取数据:
export default async function Page() {
  const response = await fetch(
    'https://example.com/api/posts',
    {
      cache: 'no-store',
    },
  );

  const posts = await response.json();

  return (
    <ul>
      {posts.map((post: { id: string; title: string }) => (
        <li key={post.id}>{post.title}</li>
      ))}
    </ul>
  );
}
Nuxt 则更常见的是:
<script setup lang="ts">
const { data: posts } = await useFetch('/api/posts');
</script>

<template>
  <ul>
    <li v-for="post in posts ?? []" :key="post.id">
      {{ post.title }}
    </li>
  </ul>
</template>
两种方式都可以实现服务端获取数据并生成页面,但 Nuxt 的 useFetch 与 useAsyncData 额外整合了 SSR 数据传递、响应式状态和客户端导航等机制。
Next.js 的 Server Component 则允许组件直接在服务端调用数据库访问层或其他服务端逻辑,而不一定需要先通过自己定义的 HTTP API。
因此,如果 Next.js 页面和数据库访问逻辑部署在同一个服务端应用中,通常可以直接调用数据访问函数,而不必在服务端组件内部再次请求自身的 API 地址。
3. 缓存与静态生成的差异
两个框架都支持动态渲染、静态生成和缓存,但具体的默认行为、配置方式和缓存失效机制有所区别。
Next.js 提供 fetch 缓存选项、重新验证机制以及与路由相关的缓存能力。开发者需要理解数据缓存和页面输出缓存之间的区别。
Nuxt 则可以结合 routeRules、Nitro 缓存能力和 useFetch 等数据获取机制配置缓存与渲染行为。
例如,Nuxt 可以在配置中设置路由规则:
// nuxt.config.ts

export default defineNuxtConfig({
  routeRules: {
    '/': {
      prerender: true,
    },

    '/posts/**': {
      swr: 60,
    },

    '/admin/**': {
      ssr: false,
    },
  },
});
这里的示例表达了几种常见意图:
- 首页可以在构建阶段预渲染。
- 文章页面可以采用带有重新验证时间的缓存策略。
- 管理后台可以采用客户端渲染。
SWR 在这里指的是 stale-while-revalidate 类似的缓存策略。具体的缓存行为取决于 Nitro 版本、部署适配器及平台能力,不能简单地认为任何环境下都一定会得到完全相同的结果。
对于带有用户身份、权限信息或个性化数据的页面,尤其需要谨慎使用共享页面缓存,避免将某个用户的 HTML 或数据缓存给其他用户。
4. 部署模式不同
Next.js 可以部署到 Node.js 服务端,也可以通过支持的托管平台运行。部分静态页面可以直接部署到 CDN,但依赖服务端能力的路由仍需要对应运行环境。
Nuxt 的服务端能力主要由 Nitro 提供。Nitro 支持生成适用于 Node.js、静态托管以及部分云平台的部署产物。
两者都不意味着项目只要运行一次构建命令,就可以自动部署到所有平台而不需要考虑差异。
例如,使用静态部署时,动态数据库查询、服务端 API 和请求时 SSR 等能力可能无法按照普通 Node.js 服务的方式运行。部署之前应当明确目标平台支持的功能,并验证缓存、路由和运行时行为。
六、实战对比:实现同一个博客文章详情页
假设我们要实现一个博客页面,包含以下内容:
- 文章标题。
- 文章摘要。
- 作者信息。
- 发布时间。
- 正文内容。
- SEO 标题与描述。
文章数据结构如下:
interface Post {
  id: string;
  title: string;
  summary: string;
  content: string;
  author: string;
  publishedAt: string;
}
数据库中保存文章数据,后端提供查询接口:
GET /api/posts/:id
接下来分别使用 Next.js 和 Nuxt 实现。
1. Next.js 实现
// app/posts/[id]/page.tsx

import type { Metadata } from 'next';
import { notFound } from 'next/navigation';

interface Post {
  id: string;
  title: string;
  summary: string;
  content: string;
  author: string;
  publishedAt: string;
}

async function getPost(id: string): Promise<Post | null> {
  const response = await fetch(
    `${process.env.API_BASE_URL}/posts/${id}`,
    {
      cache: 'no-store',
    },
  );

  if (response.status === 404) {
    return null;
  }

  if (!response.ok) {
    throw new Error('获取文章失败');
  }

  return response.json();
}

export async function generateMetadata({
  params,
}: {
  params: Promise<{ id: string }>;
}): Promise<Metadata> {
  const { id } = await params;
  const post = await getPost(id);

  if (!post) {
    return {
      title: '文章不存在',
    };
  }

  return {
    title: post.title,
    description: post.summary,
  };
}

export default async function PostPage({
  params,
}: {
  params: Promise<{ id: string }>;
}) {
  const { id } = await params;
  const post = await getPost(id);

  if (!post) {
    notFound();
  }

  return (
    <article>
      <h1>{post.title}</h1>

      <p>{post.summary}</p>

      <div>
        作者:{post.author}
        {' · '}
        发布时间:
        {new Date(post.publishedAt).toLocaleDateString('zh-CN')}
      </div>

      <div>{post.content}</div>
    </article>
  );
}
这个实现通过 generateMetadata 为文章生成动态元信息,通过 notFound() 处理不存在的文章。
示例使用 cache: 'no-store',因此页面数据获取不会使用 Next.js 的持久化 fetch 数据缓存。实际生产环境中,可以根据内容更新频率调整缓存策略。
还需要注意,这里为了便于理解,将正文直接放在普通 div 中。如果文章正文是 Markdown,通常还需要使用 Markdown 解析器或专门的渲染组件。
2. Nuxt 实现
<!-- app/pages/posts/[id].vue -->

<script setup lang="ts">
interface Post {
  id: string;
  title: string;
  summary: string;
  content: string;
  author: string;
  publishedAt: string;
}

const route = useRoute();

const {
  data: post,
  error,
} = await useFetch<Post>(
  `/api/posts/${route.params.id}`,
);

if (error.value) {
  throw createError({
    statusCode: error.value.statusCode ?? 500,
    statusMessage: '获取文章失败',
  });
}

if (!post.value) {
  throw createError({
    statusCode: 404,
    statusMessage: '文章不存在',
  });
}

useSeoMeta({
  title: () => post.value?.title ?? '文章详情',
  description: () => post.value?.summary ?? '',
});
</script>

<template>
  <article v-if="post">
    <h1>{{ post.title }}</h1>

    <p>{{ post.summary }}</p>

    <div>
      作者:{{ post.author }}
      · 发布时间:
      {{ new Date(post.publishedAt).toLocaleDateString('zh-CN') }}
    </div>

    <div>{{ post.content }}</div>
  </article>
</template>
这个示例假设 /api/posts/:id 是同一个 Nuxt 应用中实现的服务端接口。
实际项目中,建议在服务端 API 层区分 404、鉴权失败和下游服务故障。如果页面查询的是不存在的文章,应当明确返回 404,而不是把所有错误都映射成同一个状态。
对于服务端渲染,页面在服务端生成 HTML 时就可以包含文章标题、摘要和正文。浏览器接收 HTML 后即可显示这些内容,再根据页面的交互需求完成客户端水合。
3. 两种实现的主要差异
虽然两个示例最终都能生成包含文章内容的 HTML,但代码组织方式有明显区别。
Next.js 的 App Router 允许在 Server Component 中直接调用异步函数,并使用 generateMetadata 生成元信息。对于熟悉 React 的开发者来说,这种方式与 React 组件体系结合紧密。
Nuxt 则利用 Vue 单文件组件、useFetch、useSeoMeta 等 API 将数据获取、响应式状态和页面模板组织在一起。对于 Vue 开发者而言,通常更容易沿用已有的组件开发习惯。
实际项目中,还应该考虑 Markdown 渲染、安全过滤、分页、相关文章、评论和缓存更新等功能。框架可以帮助完成页面渲染,但并不会自动解决所有业务逻辑问题。
七、SSR 的性能优化与常见问题
SSR 可以改善某些页面的首屏体验和内容可访问性,但它同时引入了服务端渲染成本。如果使用不当,页面反而可能变慢。
1. 服务端渲染也可能很慢
SSR 的响应速度受到多个阶段影响:
接收请求
   |
   v
执行服务端代码
   |
   v
查询数据库或调用 API
   |
   v
渲染组件
   |
   v
返回 HTML
如果数据库查询需要 800ms,那么即使组件渲染只需要 20ms,页面仍然需要等待数据获取完成。
因此,SSR 优化通常要从数据获取入手:
- 为数据库查询建立合理索引。
- 避免串行执行互不依赖的请求。
- 合理使用缓存。
- 控制服务端 API 调用次数。
- 避免在渲染过程中执行耗时的非必要操作。
例如,两个独立请求可以并行执行:
const [posts, categories] = await Promise.all([
  getPosts(),
  getCategories(),
]);
相比顺序等待两个请求,这种方式通常能够缩短总等待时间。
不过,并不是所有请求都适合并行。如果第二个请求依赖第一个请求的结果,就必须按依赖关系执行。
2. 避免服务端和客户端重复请求
在 SSR 应用中,如果数据获取逻辑设计不当,可能出现服务端请求一次、浏览器水合后再请求一次的情况。
Nuxt 的 useFetch 和 useAsyncData 可以通过 SSR 数据序列化与状态复用,避免许多常见的重复请求。
Next.js 则可以利用 Server Component、数据获取缓存和组件边界设计数据流,减少不必要的客户端请求。
但是,如果组件中又使用 onMounted 或 useEffect 重新请求同一份数据,就仍然可能产生重复请求。应当根据数据的用途,明确由服务端获取、客户端获取还是两者分工完成。
3. 处理服务端与客户端渲染不一致
SSR 页面需要保证服务端生成的 HTML 与客户端首次水合时的渲染结果一致。
如果两边得到的初始结果不同,就可能产生 Hydration Mismatch。
常见原因包括:
- 直接使用
window、document等浏览器 API。 - 服务端与客户端使用不同的时间或随机值。
- 服务端和客户端的时区设置不同。
- 根据浏览器本地存储生成初始页面内容。
- HTML 结构不合法,导致浏览器自动修正 DOM。
例如:
<script setup lang="ts">
const width = window.innerWidth;
</script>
这段代码在服务端执行时会因为没有 window 而报错。
如果确实需要读取浏览器窗口大小,应将相关逻辑放在客户端执行的生命周期或封装好的客户端组合式 API 中,而不是在服务端渲染阶段直接访问浏览器对象。
同样地,Next.js 中也需要明确区分服务端可用的 API 和浏览器专属 API。添加 'use client' 可以定义客户端组件边界,但不能保证组件中的所有代码都只会在浏览器中执行,因为初始页面仍可能参与服务端预渲染。
4. 合理使用缓存
缓存是降低 SSR 成本的重要手段,但缓存策略必须与数据的更新频率和权限模型一致。
例如:
- 博客文章正文可以采用较长时间的缓存。
- 文章编辑后可以主动失效对应缓存。
- 用户个人资料需要考虑用户身份和权限。
- 管理后台中的敏感数据不应被错误地共享缓存。
- 高频变化的数据可能更适合短缓存或请求时获取。
尤其需要注意,缓存 HTML 与缓存数据库查询结果并不是一回事。一个页面可能使用了缓存的文章数据,但仍然在每次请求时执行页面渲染;反过来,一个完整的页面输出也可能被缓存。
生产环境中应该明确每一层缓存的作用和失效机制,避免因共享缓存导致用户数据泄露,或者因为缓存过期策略不当而长期显示旧内容。
5. 流式 SSR 与渐进式页面输出
传统 SSR 可能需要等待整个页面或关键数据准备完成后,再返回完整 HTML。
流式 SSR 则可以逐步输出已经准备好的页面内容,让浏览器更早开始解析和显示页面。
React 的 Streaming SSR 可以结合 Suspense 使用;Nuxt 和 Vue 的 SSR 能力也可以在适当的运行环境与组件设计下利用流式输出。
不过,流式渲染并不意味着所有页面都能自动获得更好的体验。页面结构、数据依赖、缓存和部署平台都会影响实际效果。如果页面关键内容仍然依赖一个很慢的请求,那么流式输出也无法凭空生成尚未获取的数据。
八、什么时候应该使用 SSR
SSR 并不是所有 Web 应用的默认最优解。选择渲染方式时,应该先明确页面的业务属性。
适合优先考虑 SSR 的场景:
- 个人博客、新闻网站和内容平台。
- 商品详情、搜索落地页和营销页面。
- 需要服务端根据请求生成内容的页面。
- 对首屏内容可访问性和搜索引擎抓取有较高要求的公开页面。
适合优先考虑 SSG 的场景:
- 个人技术博客。
- 产品介绍页面。
- 开发文档。
- 更新频率较低的公开内容网站。
适合优先考虑 CSR 的场景:
- 企业后台管理系统。
- 内部运营平台。
- 以复杂表单和高频交互为主的工具。
- 对搜索引擎收录没有明显需求的内部应用。
实际项目中也可以混合使用。例如,博客首页和文章详情采用静态生成或 SSR,评论和点赞采用客户端交互,管理后台则使用 CSR。
这种混合渲染方式通常比强行要求所有页面使用同一种模式更加合理。
总结
服务端渲染的核心是将页面 HTML 的生成工作放到服务端完成,让浏览器能够更早获取有意义的页面内容。与 CSR 相比,SSR 可以改善内容可访问性和某些场景下的首屏体验,但也会增加服务端计算、数据获取和缓存管理的复杂度。
Next.js 和 Nuxt 分别代表 React 与 Vue 生态中的两种重要实现。Next.js 的 App Router 强调 Server Component、Client Component 和框架级数据获取能力;Nuxt 则围绕 Vue 单文件组件、useFetch、useAsyncData 和 Nitro 构建完整的全栈开发体验。
对于使用 Vue 3 的开发者来说,Nuxt 通常是更自然的选择。对于 React 团队,Next.js 则拥有更紧密的生态集成。
最终,真正重要的不是追求 SSR 这个技术标签,而是根据页面内容、更新频率、交互复杂度、SEO 需求和部署成本,选择合适的渲染方式。
对于一个个人博客,静态生成可能已经足够;对于需要实时数据的商品详情页,SSR 与缓存结合可能更合适;对于复杂的内部管理系统,CSR 反而可能更简单。
好的前端架构不是让所有页面采用同一种渲染模式,而是让每一种页面都在合适的地方完成渲染。